Réponse courte. Il n'existe pas de « plus fiable » honnête parmi Claude, ChatGPT et Gemini. Sur le seul benchmark public qui mesure le contenu inventé dans des résumés, l'écart à l'intérieur d'une même marque dépasse l'écart entre marques. Choisissez selon la version du modèle et la tâche, et vérifiez tout ce sur quoi vous allez agir. Données lues le 2026-10-26.
Claude est-il plus fiable que Gemini ou ChatGPT ?
Personne ne peut l'affirmer en général. La fiabilité dépend de la version du modèle, de la tâche, et de la possibilité de vérifier la réponse. La meilleure preuve publique que nous ayons trouvée mesure une seule chose, étroite : la fréquence à laquelle un modèle ajoute une information absente du document qu'on lui a demandé de résumer.
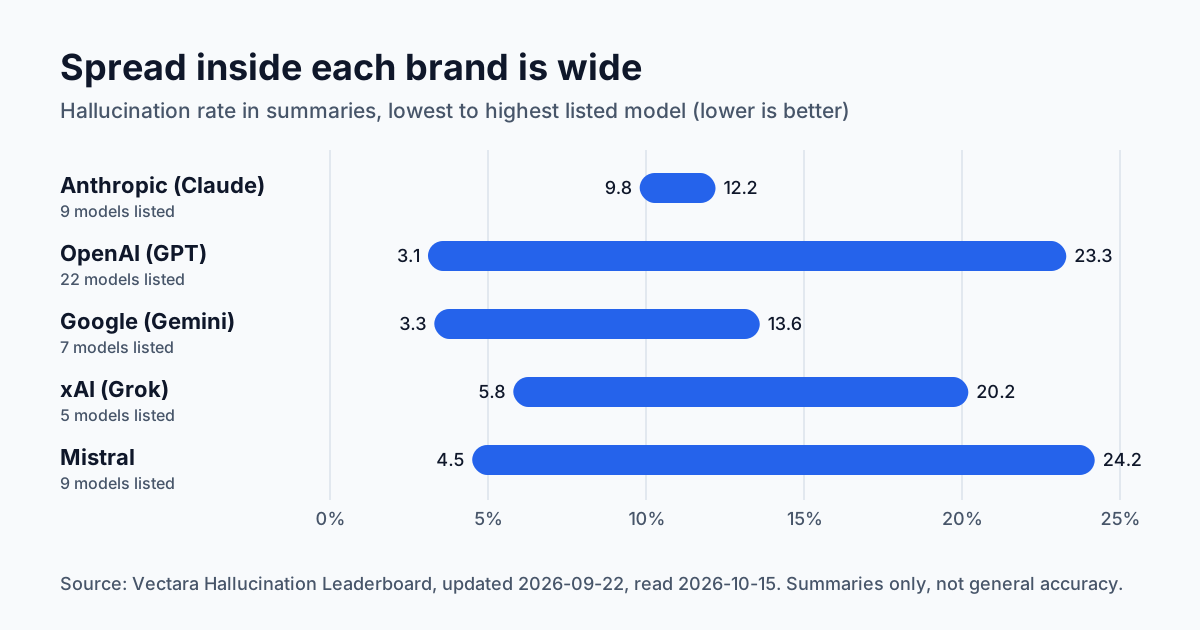
Le classement Vectara Hallucination Leaderboard (mis à jour le 2026-10-22, 111 modèles) donne ces fourchettes pour les éditeurs que nous suivons :
Source : github.com/vectara/hallucination-leaderboard. Plus bas est meilleur. Notre compilation, avec chaque ligne, est sur la page des benchmarks d'hallucination.
Que dit ce benchmark, et que ne dit-il pas ?
Il montre que deux modèles d'une même entreprise peuvent être très éloignés : les modèles OpenAI listés vont de 3,1 % à 23,3 %. Choisir « ChatGPT » ou « Gemini » comme marque dit peu de chose. La version compte.
Il ne dit pas quel assistant a raison le plus souvent face à une question ouverte. Il teste la fidélité à un texte fourni, dans des résumés. Il ne dit rien des maths, du droit, de la médecine ni de l'actualité récente. Voyez-le comme un signal parmi d'autres, pas comme un classement de la véracité générale. Satcove ne publie pas de classement des modèles.
Pourquoi les trois répondent-ils différemment à la même question ?
Quatre causes habituelles : une lecture différente de la question, une date de connaissances différente, un sujet réellement ouvert, ou un modèle qui invente un détail. Les trois premières sont normales. La quatrième est le risque. Notre guide sur quoi faire quand ChatGPT, Claude et Gemini ne sont pas d'accord propose une routine en cinq étapes, reprise aussi dans ce guide du blog.
Que fait chaque assistant que les autres ne font pas ?
Restons pratiques plutôt que partisans :
- Claude propose Projects et Claude Code dans ses offres payantes (claude.com/pricing, lu le 2026-10-18).
- ChatGPT a des offres Go, Plus et Pro sur chatgpt.com/pricing (lu le 2026-10-18) ; consultez cette page pour le contenu de chaque offre.
- Gemini : les offres payantes (Google AI Plus, Pro, Ultra) regroupent plus d'accès aux modèles avec 400 Go à 20 To de stockage Google (gemini.google/subscriptions, lu le 2026-10-15).
Ce sont des caractéristiques d'offres tirées des pages des éditeurs, pas des affirmations sur celui qui est le plus exact. Pour les prix actuels, voir la page des prix des abonnements.
Comment décider, alors ?
- Adaptez le modèle à la tâche. Résumer un document que vous fournissez est le cas où s'applique le benchmark ci-dessus. Les questions ouvertes demandent une autre vérification.
- Rendez l'affirmation vérifiable. Demandez des sources, puis ouvrez-les. Une réponse assurée sans source est une piste, pas un fait.
- Comparez deux ou trois réponses sur tout ce qui compte. L'accord augmente un peu votre confiance. Le désaccord vous indique précisément quelle affirmation vérifier. L'accord n'est toujours pas une preuve, car les modèles peuvent avoir été entraînés sur des données qui se recoupent.
- Allez à une source primaire pour les décisions d'argent, de santé, de droit ou de sécurité.
Où se place un outil multi-modèles ?
Satcove envoie une question à six modèles et montre où ils s'accordent et où ils divergent, avec un score d'accord. Cela ne rend pas la réponse vraie et nous ne le prétendons jamais. Cela vous évite l'étape de copier-coller de la routine ci-dessus. Les applications d'un seul éditeur restent préférables pour de longues sessions approfondies dans un même écosystème.
Dans Satcove. Posez la question une fois et voyez où les modèles s'accordent et où ils divergent, puis ouvrez Verify pour vérifier quelles affirmations ont des preuves derrière elles. Nos tests et notre méthode sont sur la page benchmark. L'accord augmente un peu la confiance ; ce n'est pas une preuve.
FAQ
Quelle IA hallucine le moins ? Sur le benchmark de résumés de Vectara, les taux les plus bas appartiennent à des modèles de plusieurs éditeurs différents, et chaque éditeur a aussi des modèles aux taux bien plus élevés. Voir le tableau ci-dessus et consulter le classement pour l'ordre actuel.
Le modèle le plus récent est-il toujours plus sûr ? Pas forcément. Dans le classement, les versions plus récentes d'une marque ne font pas toujours mieux que les anciennes. Regardez le modèle précis.
Peut-on se fier à une IA qui cite des sources ? Seulement après avoir ouvert la source. Les modèles peuvent citer des pages qui ne soutiennent pas l'affirmation, ou qui n'existent pas.
Chiffres du benchmark lus sur le classement Vectara le 2026-10-26. Les taux changent à chaque mise à jour.