Respuesta corta. No existe un «más fiable» honesto entre Claude, ChatGPT y Gemini. En el único benchmark público que mide el contenido inventado en resúmenes, la diferencia dentro de una misma marca es mayor que la diferencia entre marcas. Elija según la versión del modelo y la tarea, y verifique todo aquello sobre lo que vaya a actuar. Datos leídos el 2026-10-26.
¿Es Claude más fiable que Gemini o ChatGPT?
Nadie puede afirmarlo en general. La fiabilidad depende de la versión del modelo, de la tarea y de si la respuesta se puede comprobar. La mejor evidencia pública que encontramos mide una sola cosa, y estrecha: con qué frecuencia un modelo añade información que no está en el documento que se le pidió resumir.
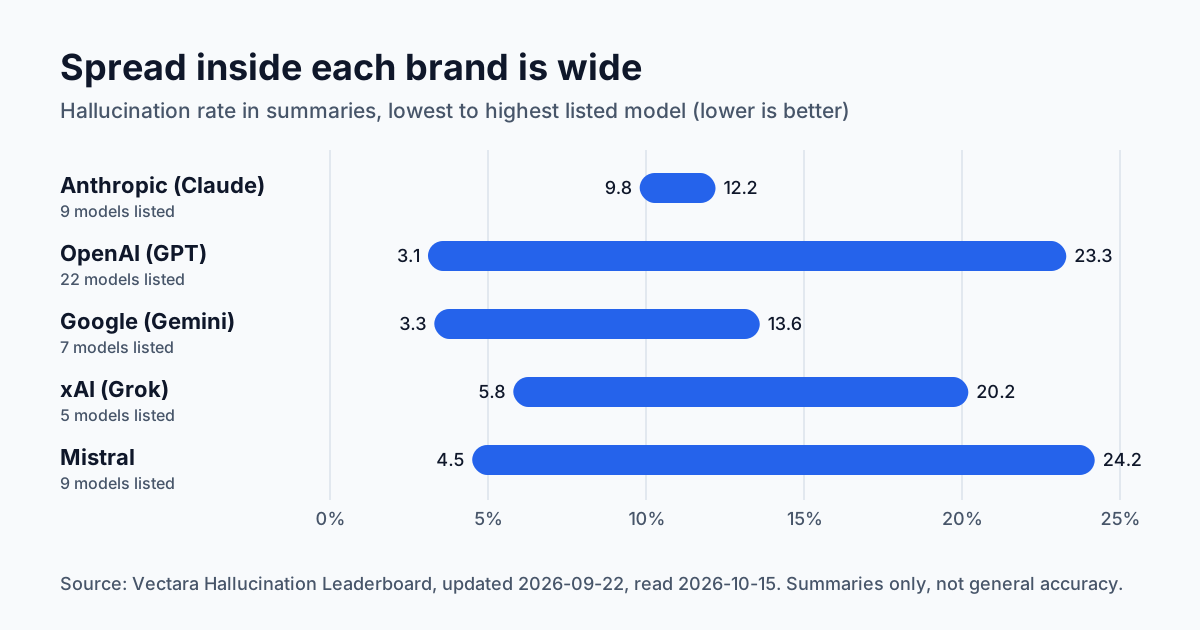
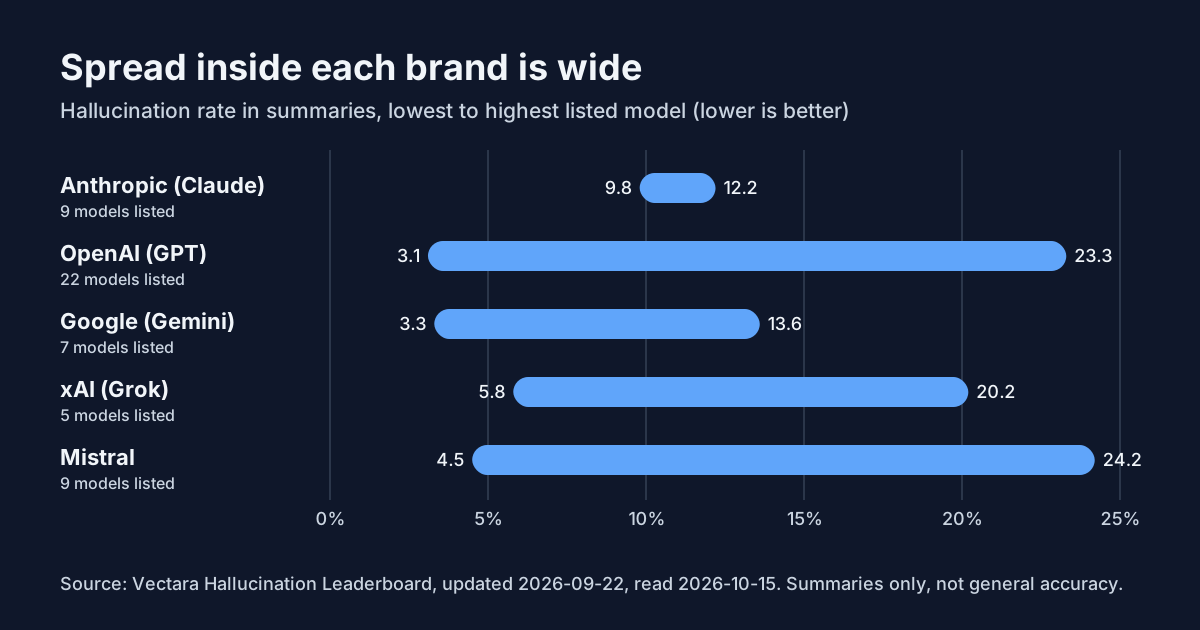
El Vectara Hallucination Leaderboard (actualizado el 2026-10-22, 111 modelos) da estos rangos para los proveedores que seguimos:
Fuente: github.com/vectara/hallucination-leaderboard. Menor es mejor. Nuestra recopilación, con todas las filas, está en la página de benchmarks de alucinación.
¿Qué dice este benchmark y qué no dice?
Dice que dos modelos de la misma empresa pueden estar muy separados: los modelos de OpenAI listados van del 3,1 % al 23,3 %. Elegir «ChatGPT» o «Gemini» como marca dice poco. La versión importa.
No dice qué asistente acierta más ante una pregunta abierta. Mide la fidelidad a un texto proporcionado, en resúmenes. No dice nada sobre matemáticas, derecho, medicina ni actualidad reciente. Tómelo como una señal, no como un ranking de veracidad general. Satcove no publica un ranking de modelos.
¿Por qué los tres responden distinto a la misma pregunta?
Cuatro causas habituales: una lectura distinta de la pregunta, una fecha de corte de conocimiento distinta, un tema realmente abierto, o un modelo que se inventa un detalle. Las tres primeras son normales. La cuarta es el riesgo. Nuestra guía sobre qué hacer cuando ChatGPT, Claude y Gemini no coinciden ofrece una rutina de cinco pasos, que también recoge esta guía del blog.
¿Qué hace cada asistente que los otros no hacen?
Mantengámonos prácticos, no tribales:
- Claude incluye Projects y Claude Code en sus planes de pago (claude.com/pricing, leído el 2026-10-18).
- ChatGPT tiene los niveles Go, Plus y Pro en chatgpt.com/pricing (leído el 2026-10-18); consulte esa página para ver qué incluye cada nivel.
- Gemini: los planes de pago (Google AI Plus, Pro, Ultra) agrupan más acceso a modelos con entre 400 GB y 20 TB de almacenamiento de Google (gemini.google/subscriptions, leído el 2026-10-15).
Son características de planes tomadas de las páginas de los proveedores, no afirmaciones sobre quién es más preciso. Para los precios actuales, vea la página de precios de suscripciones.
¿Cómo decidir, entonces?
- Ajuste el modelo a la tarea. Resumir un documento que usted aporta es donde se aplica el benchmark anterior. Las preguntas abiertas requieren otra comprobación.
- Haga la afirmación comprobable. Pida fuentes y ábralas. Una respuesta segura sin fuente es una pista, no un hecho.
- Compare dos o tres respuestas en lo importante. El acuerdo aumenta un poco su confianza. El desacuerdo le dice exactamente qué afirmación verificar. El acuerdo sigue sin ser una prueba, porque los modelos pueden haberse entrenado con datos que se solapan.
- Acuda a una fuente primaria en decisiones de dinero, salud, legales o de seguridad.
¿Dónde encaja una herramienta multimodelo?
Satcove envía una pregunta a seis modelos y muestra dónde coinciden y dónde se separan, con una puntuación de acuerdo. No hace que la respuesta sea verdadera y nunca lo afirmamos. Le ahorra el paso de copiar y pegar de la rutina anterior. Las aplicaciones de un solo proveedor siguen siendo mejores para sesiones largas y profundas dentro de un mismo ecosistema.
En Satcove. Pregunte una vez y vea dónde coinciden y dónde se separan los modelos; después abra Verify para comprobar qué afirmaciones tienen pruebas detrás. Nuestras pruebas y método están en la página de benchmark. El acuerdo aumenta un poco la confianza; no es una prueba.
Preguntas frecuentes
¿Qué IA alucina menos? En el benchmark de resúmenes de Vectara, las tasas más bajas corresponden a modelos de varios proveedores distintos, y cada proveedor tiene también modelos con tasas mucho más altas. Vea la tabla anterior y consulte el ranking para el orden actual.
¿El modelo más nuevo es siempre más seguro? No necesariamente. En el ranking, las versiones más nuevas de una marca no siempre puntúan mejor que las anteriores. Mire el modelo concreto.
¿Puedo fiarme de una IA que cita fuentes? Solo después de abrir la fuente. Los modelos pueden citar páginas que no respaldan la afirmación, o que no existen.
Cifras del benchmark leídas del ranking de Vectara el 2026-10-26. Las tasas cambian con cada actualización.